Preservación digital

Del patrimonio documental al conocimiento relacional

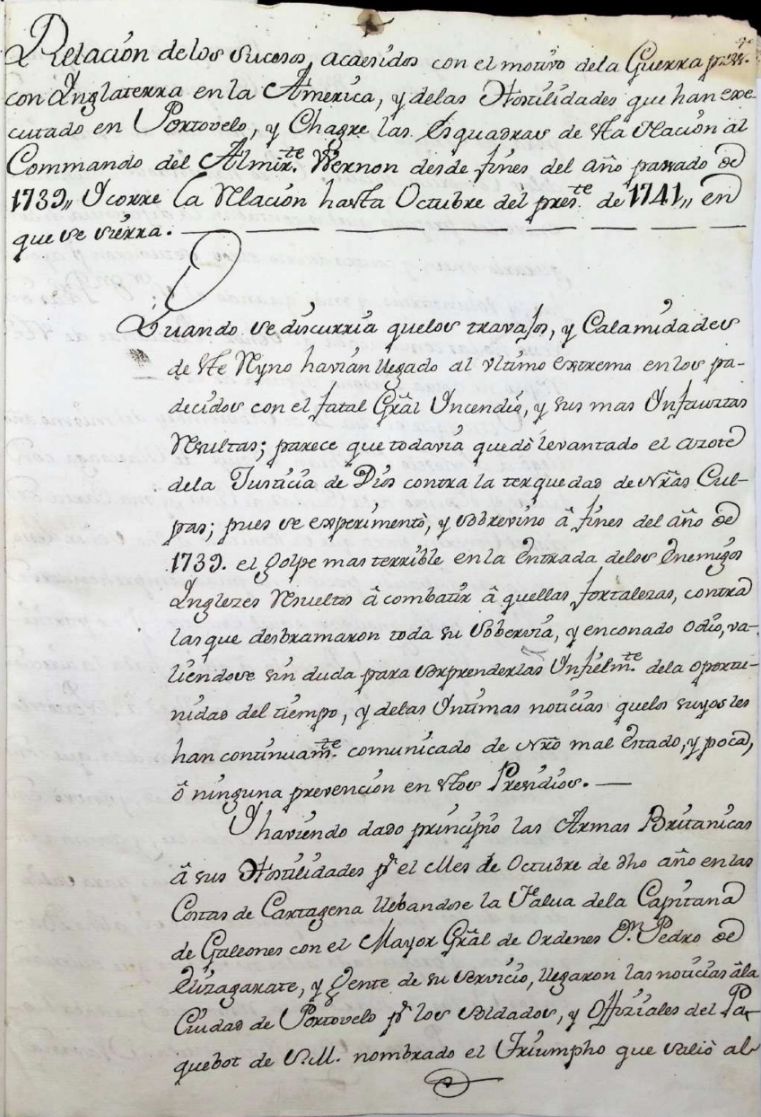
El proyecto reúne la conservación física y el análisis computacional para estudiar colecciones históricas de periódicos y patrimonio documental. Los materiales históricos se estabilizan, documentan y digitalizan antes de que pipelines computacionales reproducibles extraigan entidades, normalicen información y conecten actores, eventos, fuentes y territorios. Estos datos estructurados se modelan como redes relacionales y de conocimiento para revelar patrones históricos, comunidades y narrativas emergentes difíciles de identificar mediante el análisis individual de documentos.

Preservación digital

Conservación y preservación

Diseñamos protocolos físicos para estabilizar, documentar y resguardar cada pieza antes de digitalizarla.

  • Limpieza, reparación y estabilización del soporte en papel.
  • Digitalización guiada con iluminación controlada y registro cromático.
  • Inventario de procedencias y condiciones para futuros tratamientos.

Modelado computacional

Aplicamos pipelines reproducibles para extraer entidades, normalizar datos y construir grafos dinámicos.

  • Extracción automática de entidades y alineación temporal.
  • Grafos de concurrencia con Barabasi-Albert y medidas de centralidad.
  • Dashboards que cruzan colecciones, actores y territorios.

Metodología integrada

Cada proyecto articula laboratorios de conservación con células computacionales que operan en paralelo.

01·LEDS

Diagnóstico material

Evaluamos riesgos, priorizamos piezas y definimos la estrategia de captura con fichas técnicas.

02·LEDS

Normalización documental

Etiquetamos entidades, eventos y fuentes; homologamos formatos y trazamos correspondencias.

03·LEDS

Análisis relacional

Construimos grafos de concurrencia/coocurrencia para revelar patrones históricos y narrativas.

Modelos y algoritmos

Combinamos enfoques estadísticos y de grafos para revelar dinámicas latentes en los corpus.

Barabasi-Albert

Simula crecimiento preferencial para contrastar redes reales con modelos teóricos y detectar hubs.

Detección de comunidades

Aplicamos Leiden/Louvain para segmentar subredes por periodos, actores o territorios.

Embeddings semánticos

Modelos multilingues que agrupan narrativas y conceptos afines para consulta y recomendaciones.

Colaboracion

Comparte tu acervo o pregunta por el pipeline

Buscamos archivos municipales, colecciones familiares y fondos de prensa para ampliar el laboratorio.

Escribir al laboratorio